작성: Sally Ward-Foxton
2026년 6월 25일
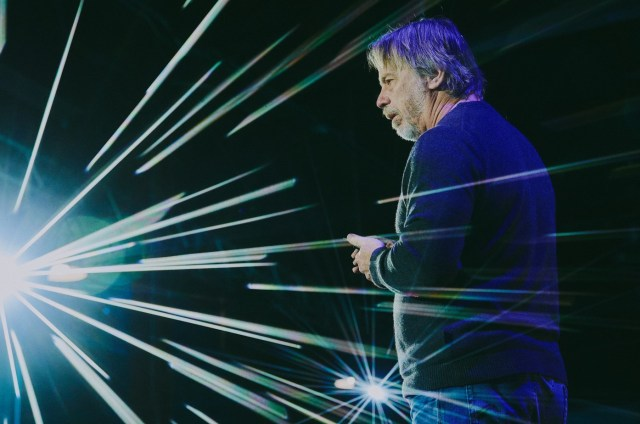
미국 캘리포니아주 산타클라라 — 1년 전 EE Times가 Tenstorrent의 CEO인 Jim Keller의 사무실을 방문했을 당시, 그의 사무실 문 밖 화이트보드에는 “우리는 승리할 것이다!(We’re going to WIN!)”라는 문구가 적혀 있었다. 1년 후 다시 방문했을 때는 “세상에, 정말 빠르다!(Holy Shit, That’s Fast!)”라는 문구로 바뀌어 있었다.
Tenstorrent가 TT-Deploy 행사에서 자사 칩을 대규모 환경에 배치했을 때 어떤 성능을 발휘하는지에 대한 초기 시연을 공개한 이후, Keller는 EE Times와의 인터뷰에서 Tenstorrent의 BlackHole Galaxy 서버는 GPU는 물론, 보다 특화된 AI 하드웨어보다도 뛰어난 성능을 낼 수 있다고 말했다.
Tenstorrent의 높은 토큰 처리 성능은 대규모 텐서를 수백 개의 칩에 손쉽게 분산할 수 있는 구조에서 비롯된다고 Keller는 설명했다. Galaxy 서버는 서버 한 대당 56개의 Ethernet 포트를 제공하는 반면, 일반적인 GPU 서버는 서버당 외부 포트가 약 8개 수준에 불과하다.
Keller는 IBM이 1960년대에 제시한 Rent's Rule을 언급했다. 이 법칙은 논리 회로 블록에 필요한 I/O가 논리 규모에 비례하지 않고 그보다 느린 속도로 증가한다는 내용을 담고 있다. 실제로는 연산 영역이 통신을 위한 입출력 인터페이스보다 더 빠르게 증가하게 되며, 이는 다른 아키텍처에서 흔히 나타나는 치명적인 한계라고 그는 설명했다.
"새로운 법칙은 없습니다."
그는 이어 "AI 컴퓨팅의 기본 원리는 이미 1970년대 HPC(고성능 컴퓨팅)에서 확립된 것이며, 수십 년 동안 충분히 연구되어 왔습니다."라고 말했다.
그는 성공적인 AI 인프라는 결국 연산(Compute), 메모리(Memory), 그리고 I/O의 균형에 달려 있다고 강조했다.
"AI는 대부분 행렬(Matrix) 연산과 비선형 벡터 연산으로 이루어집니다. 이를 빠르게 실행하려면 연산에 필요한 데이터와 결과를 저장할 충분한 SRAM과, 메모리·텐서 프로세서·칩 사이에서 데이터를 이동시키기 위한 버퍼가 필요합니다. Tenstorrent는 이러한 구조를 갖추고 있습니다. 메모리가 지나치게 크다고 해서 큰 도움이 되는 것은 아니며, 반대로 너무 작으면 성능에 매우 큰 문제가 발생합니다."
성공적인 IPO 이후 대규모 모델 성능으로 주목받고 있는 Tenstorrent의 경쟁사 Cerebras는 Kimi K2.6(1T) 모델의 성능을 공개했다. 이는 Cerebras가 지금까지 공개한 모델 가운데 가장 큰 규모이며, 자사 CS3 하드웨어에서 초당 981토큰(Token/s)의 처리 속도를 달성할 수 있다고 밝혔다.
이에 대해 Keller는 Tenstorrent가 대규모 BlackHole Galaxy 서버 구성을 통해 훨씬 낮은 하드웨어 비용으로도 이 성능을 뛰어넘을 수 있다고 말했다.
"Cerebras의 IPO와 그 이후의 기업 가치 상승은 우리에게도 도움이 됐습니다. 특히 우리는 모든 면에서 그들을 뛰어넘을 것이기 때문입니다."
"도전, 받아들이겠습니다!"
분리형 추론(Disaggregated Inference)
시장 선도 기업인 NVIDIA는 Groq의 기술을 라이선스하여 분리형 추론(Disaggregated Inference)이라 불리는 방식으로 LLM 추론 과정 중 디코드(Decode) 단계를 가속하고 있다. 이 방식에서는 Groq 칩이 탑재된 랙 1대당, 프리필(Prefill) 용으로 약 1개의 NVIDIA CPU·GPU 랙과, 대용량 KV 캐시(KV Cache)를 저장하기 위한 약 2개의 랙이 추가로 필요하다.
Keller는 Tenstorrent는 빠른 디코드를 위해 이러한 추가 구성이 필요하지 않다고 말했다.
"KV 캐시를 어떻게 처리하느냐는 질문을 자주 받습니다."
그는 이어 "KV 캐시는 디코드를 수행하는 동일한 칩의 DRAM에 저장됩니다. 우리는 그 부분을 따로 신경 쓰지 않습니다. 그만큼 이 부분을 매우 잘 처리하고 있습니다."라고 말했다.
Keller는 핵심은 Tenstorrent가 원하는 만큼의 텐서 프로세서를 자유롭게 연결할 수 있다는 점이라고 설명했다. 칩 수가 충분하면 텐서는 전부 SRAM에 저장되지만, 칩 수가 부족한 경우에는 일부 성능 저하를 감수하는 대신 DRAM에서 데이터를 스트리밍하여 처리할 수 있다. 그는 Groq나 Cerebras처럼 DRAM이 없는 아키텍처는 이러한 방식이 불가능하다고 지적했다.
"그들도 대규모 모델을 실행할 수는 있습니다. 다만 많은 하드웨어가 필요합니다."
"우리의 해답은 비교적 적은 규모의 하드웨어로도 대형 모델을 실행할 수 있다는 것입니다. 그리고 매우 높은 토큰 처리 속도가 필요하다면, 우리는 원하는 수준까지 토큰 처리 속도를 끌어올릴 수 있습니다."
그렇다면 NVIDIA의 분리형 추론 아키텍처처럼, Tenstorrent 하드웨어를 GPU와 함께 사용해 디코드 성능을 가속할 수도 있을까?
"이미 Galaxy를 활용해 기존에 구매한 GPU를 가속하는 고객이 있습니다." Keller는 이렇게 말했다. "우리의 BlackHole 칩이 탑재된 PCIe 카드를 사용하고 있으며, Layer 2 Ethernet을 통해 데이터를 전송하기 때문에 기존 시스템에 연결하는 것도 매우 쉬웠습니다."
Keller는 이 방식을 통해 해당 고객이 토큰 처리 속도를 2~3배 향상시켰다고 말했다.
"처음부터 Tenstorrent만 도입했다면 비용은 더 저렴했을 것입니다. 우리는 프리필(Prefill)도 처리할 수 있고, 전체 구조도 더 단순하기 때문입니다."
그는 이어 "하지만 그 고객은 이미 GPU를 구매한 상태였고, 기존 투자 자산을 최대한 활용하고 싶어 했습니다."라고 설명했다.
Keller는 이러한 방식을 제품화할지 여부는 아직 확정되지 않았으며, 현재로서는 '가능성을 검토 중(Maybe)'인 단계라고 덧붙였다.
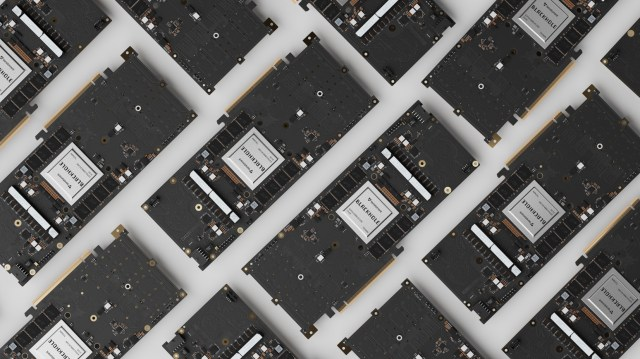
Tenstorrent는 수백 개에서 수천 개에 이르는 BlackHole 칩을 하나의 대규모 클러스터로 손쉽게 연결할 수 있다.
(출처: Tenstorrent)
워크로드 공동 설계(Workload Co-design)
Keller는 하이퍼스케일러와 최첨단 AI 연구소들이 수직 통합 구조를 갖추고 있기 때문에(즉, 자신들의 워크로드를 깊이 이해하고 있어 칩과 모델을 함께 설계할 수 있기 때문에) 하드웨어 설계에서 절대적인 우위를 가진다는 인식은 다소 과장된 측면이 있다고 말했다. Tenstorrent 역시 다른 기업들과 마찬가지로 일부 널리 사용되는 비선형 함수에 대해 하드웨어 수준의 최적화를 적용하고 있으며, 필요에 따라 이러한 기능은 차세대 실리콘에서 계속 개선해 나갈 수 있다고 설명했다.
Keller는 칩 설계에서 중요한 요소는 대규모 모델에 적합한 구조를 갖추는 것, 적절한 연산 정밀도를 확보하는 것, 그리고 대용량 KV 캐시와 디퓨전(Diffusion)처럼 연산량이 많은 워크로드를 모두 효율적으로 처리하는 것이라고 말했다.
"지금까지는 DRAM, SRAM, 연산 성능, Matrix-Vector 연산, 그리고 NoC(Network-on-Chip)의 균형만 잘 맞춰져 있다면 모든 것이 제대로 동작했습니다. Rent's Rule은 여전히 유효한 법칙인 것 같습니다."
또 다른 오래된 법칙으로는 암달의 법칙(Amdahl's Law)이 있다. 이 법칙은 일반적으로 전체 워크로드의 성능 향상은 가속할 수 없는 부분에 의해 결국 제한된다는 사실을 설명하는 데 사용된다.
"에이전트형 컴퓨팅(Agentic Computing)은 암달의 법칙이 그대로 적용되는 문제입니다." Keller는 이렇게 말했다. "AI는 엄청난 양의 연산을 필요로 했기 때문에 CPU는 AI 작업을 전달한 뒤 결과가 나올 때까지 기다리기만 하면 됐습니다. 하지만 이제 AI가 충분히 빨라지면서 병목이 오히려 일반적인 스칼라(Scalar) 연산 영역으로 이동했고, 그 결과 CPU의 중요성이 다시 커지고 있습니다."
IPO를 향한 행보
Keller는 Intel과 Qualcomm을 포함한 여러 기업의 인수 제안설에 대해서는 언급을 피했다. 다만 Tenstorrent의 하드웨어 IP를 소개하기 위해 두 회사의 CEO는 물론, 주요 하이퍼스케일러들과 실제로 만난 것은 사실이라고 밝혔다.
"우리의 RISC-V CPU IP는 정말 뛰어나기 때문에, 그들 가운데 한 곳과 큰 계약을 맺기를 기대하고 있습니다."
그는 이어 "한 하이퍼스케일러는 소형 AI 칩을 위해 우리의 AI IP에도 관심을 보이고 있습니다."라고 말했다.
Keller는 하이퍼스케일러들이 AI를 위한 자체 대형 칩을 개발하고 있지만, 엣지 디바이스에 사용되는 소형 AI 칩은 단순히 그 IP를 축소한 버전으로 해결할 수는 없다고 설명했다. Tenstorrent의 AI IP는 확장성을 고려해 설계되었으며, 이미 완전한 제품 형태로 제공되고 있다. (예를 들어 하나의 코어부터 최대 1,000개의 코어까지 확장하는 데 필요한 모든 요소를 갖추고 있다고 Keller는 설명했다.)
지난 6개월 동안 Tenstorrent의 경쟁 스타트업들은 (사실상의) 인수와 IPO라는 두 가지 큰 성과를 거뒀다. Keller는 Tenstorrent 역시 IPO를 목표로 하고 있으며, 이를 위해 공급망과 글로벌 사업 기반을 확대하고 있다고 밝혔다.
"현재 투자자들은 IPO에 매우 큰 기대를 걸고 있습니다."
그렇다면 Tenstorrent가 디코드 가속기로 활용될 수 있다는 점이 GPU 기업에게 매력적인 인수 대상이 될 가능성을 의미하는 것일까? Keller는 인수보다는 전략적 제휴나 공동 시장 진출(Joint Go-to-Market)이 이루어질 가능성이 더 높다고 말했다.
그는 국가 단위 AI 인프라(Sovereign Infrastructure)와 주요 프런티어 AI 연구소 모두 하드웨어와 소프트웨어에 대한 주도권을 직접 확보하기를 원한다고 설명하며, "앞으로 다양한 가능성이 열려 있습니다."라고 덧붙였다.
TT-Deploy 이후 Tenstorrent는 자사 하드웨어에 대한 주문을 받기 시작했으며, 가장 큰 구매 주문은 미국 외 지역으로 공급되는 Galaxy 서버 96대 규모의 클러스터라고 Keller는 밝혔다. (Galaxy 서버 96대는 BlackHole 칩 3,072개에 해당한다.) 현재 Tenstorrent의 최대 고객은 일본의 **AI&**이며, 이 회사의 CEO는 Tenstorrent의 전 임원인 David Bennett이다.
"실제로는 이런 일이 있었습니다. NVIDIA에 1억 달러 규모의 주문을 넣은 고객들이 있었지만, NVIDIA는 1년 동안 제품을 공급하지 못했습니다. 그래서 훨씬 저렴한 2천만 달러 규모의 Tenstorrent 시스템을 선택한 것입니다."라고 Keller는 말했다.
Keller는 Tenstorrent가 현재 Galaxy 서버 1,000대를 생산 중이며, 이 가운데 최소 절반 이상은 이미 판매가 완료된 상태라고 밝혔다.
"우리 제품은 매우 잘 작동하고 있습니다. 현재 10개 고객사가 이미 Galaxy 시스템을 현장에 구축해 사용하고 있으며, 우리는 이제 개념검증(PoC) 단계를 넘어섰습니다." Keller는 이어 "후속 주문도 들어오기 시작했습니다. 이제 만족하는 고객 10곳을 만들고, 그다음에는 20곳, 그리고 30곳으로 늘려가는 것이 목표입니다."라고 말했다.
출처: EE Times

작성: Sally Ward-Foxton
2026년 6월 25일
미국 캘리포니아주 산타클라라 — 1년 전 EE Times가 Tenstorrent의 CEO인 Jim Keller의 사무실을 방문했을 당시, 그의 사무실 문 밖 화이트보드에는 “우리는 승리할 것이다!(We’re going to WIN!)”라는 문구가 적혀 있었다. 1년 후 다시 방문했을 때는 “세상에, 정말 빠르다!(Holy Shit, That’s Fast!)”라는 문구로 바뀌어 있었다.
Tenstorrent가 TT-Deploy 행사에서 자사 칩을 대규모 환경에 배치했을 때 어떤 성능을 발휘하는지에 대한 초기 시연을 공개한 이후, Keller는 EE Times와의 인터뷰에서 Tenstorrent의 BlackHole Galaxy 서버는 GPU는 물론, 보다 특화된 AI 하드웨어보다도 뛰어난 성능을 낼 수 있다고 말했다.
Tenstorrent의 높은 토큰 처리 성능은 대규모 텐서를 수백 개의 칩에 손쉽게 분산할 수 있는 구조에서 비롯된다고 Keller는 설명했다. Galaxy 서버는 서버 한 대당 56개의 Ethernet 포트를 제공하는 반면, 일반적인 GPU 서버는 서버당 외부 포트가 약 8개 수준에 불과하다.
Keller는 IBM이 1960년대에 제시한 Rent's Rule을 언급했다. 이 법칙은 논리 회로 블록에 필요한 I/O가 논리 규모에 비례하지 않고 그보다 느린 속도로 증가한다는 내용을 담고 있다. 실제로는 연산 영역이 통신을 위한 입출력 인터페이스보다 더 빠르게 증가하게 되며, 이는 다른 아키텍처에서 흔히 나타나는 치명적인 한계라고 그는 설명했다.
"새로운 법칙은 없습니다."
그는 이어 "AI 컴퓨팅의 기본 원리는 이미 1970년대 HPC(고성능 컴퓨팅)에서 확립된 것이며, 수십 년 동안 충분히 연구되어 왔습니다."라고 말했다.
그는 성공적인 AI 인프라는 결국 연산(Compute), 메모리(Memory), 그리고 I/O의 균형에 달려 있다고 강조했다.
"AI는 대부분 행렬(Matrix) 연산과 비선형 벡터 연산으로 이루어집니다. 이를 빠르게 실행하려면 연산에 필요한 데이터와 결과를 저장할 충분한 SRAM과, 메모리·텐서 프로세서·칩 사이에서 데이터를 이동시키기 위한 버퍼가 필요합니다. Tenstorrent는 이러한 구조를 갖추고 있습니다. 메모리가 지나치게 크다고 해서 큰 도움이 되는 것은 아니며, 반대로 너무 작으면 성능에 매우 큰 문제가 발생합니다."
성공적인 IPO 이후 대규모 모델 성능으로 주목받고 있는 Tenstorrent의 경쟁사 Cerebras는 Kimi K2.6(1T) 모델의 성능을 공개했다. 이는 Cerebras가 지금까지 공개한 모델 가운데 가장 큰 규모이며, 자사 CS3 하드웨어에서 초당 981토큰(Token/s)의 처리 속도를 달성할 수 있다고 밝혔다.
이에 대해 Keller는 Tenstorrent가 대규모 BlackHole Galaxy 서버 구성을 통해 훨씬 낮은 하드웨어 비용으로도 이 성능을 뛰어넘을 수 있다고 말했다.
"Cerebras의 IPO와 그 이후의 기업 가치 상승은 우리에게도 도움이 됐습니다. 특히 우리는 모든 면에서 그들을 뛰어넘을 것이기 때문입니다."
"도전, 받아들이겠습니다!"
분리형 추론(Disaggregated Inference)
시장 선도 기업인 NVIDIA는 Groq의 기술을 라이선스하여 분리형 추론(Disaggregated Inference)이라 불리는 방식으로 LLM 추론 과정 중 디코드(Decode) 단계를 가속하고 있다. 이 방식에서는 Groq 칩이 탑재된 랙 1대당, 프리필(Prefill) 용으로 약 1개의 NVIDIA CPU·GPU 랙과, 대용량 KV 캐시(KV Cache)를 저장하기 위한 약 2개의 랙이 추가로 필요하다.
Keller는 Tenstorrent는 빠른 디코드를 위해 이러한 추가 구성이 필요하지 않다고 말했다.
"KV 캐시를 어떻게 처리하느냐는 질문을 자주 받습니다."
그는 이어 "KV 캐시는 디코드를 수행하는 동일한 칩의 DRAM에 저장됩니다. 우리는 그 부분을 따로 신경 쓰지 않습니다. 그만큼 이 부분을 매우 잘 처리하고 있습니다."라고 말했다.
Keller는 핵심은 Tenstorrent가 원하는 만큼의 텐서 프로세서를 자유롭게 연결할 수 있다는 점이라고 설명했다. 칩 수가 충분하면 텐서는 전부 SRAM에 저장되지만, 칩 수가 부족한 경우에는 일부 성능 저하를 감수하는 대신 DRAM에서 데이터를 스트리밍하여 처리할 수 있다. 그는 Groq나 Cerebras처럼 DRAM이 없는 아키텍처는 이러한 방식이 불가능하다고 지적했다.
"그들도 대규모 모델을 실행할 수는 있습니다. 다만 많은 하드웨어가 필요합니다."
"우리의 해답은 비교적 적은 규모의 하드웨어로도 대형 모델을 실행할 수 있다는 것입니다. 그리고 매우 높은 토큰 처리 속도가 필요하다면, 우리는 원하는 수준까지 토큰 처리 속도를 끌어올릴 수 있습니다."
그렇다면 NVIDIA의 분리형 추론 아키텍처처럼, Tenstorrent 하드웨어를 GPU와 함께 사용해 디코드 성능을 가속할 수도 있을까?
"이미 Galaxy를 활용해 기존에 구매한 GPU를 가속하는 고객이 있습니다." Keller는 이렇게 말했다. "우리의 BlackHole 칩이 탑재된 PCIe 카드를 사용하고 있으며, Layer 2 Ethernet을 통해 데이터를 전송하기 때문에 기존 시스템에 연결하는 것도 매우 쉬웠습니다."
Keller는 이 방식을 통해 해당 고객이 토큰 처리 속도를 2~3배 향상시켰다고 말했다.
"처음부터 Tenstorrent만 도입했다면 비용은 더 저렴했을 것입니다. 우리는 프리필(Prefill)도 처리할 수 있고, 전체 구조도 더 단순하기 때문입니다."
그는 이어 "하지만 그 고객은 이미 GPU를 구매한 상태였고, 기존 투자 자산을 최대한 활용하고 싶어 했습니다."라고 설명했다.
Keller는 이러한 방식을 제품화할지 여부는 아직 확정되지 않았으며, 현재로서는 '가능성을 검토 중(Maybe)'인 단계라고 덧붙였다.
Tenstorrent는 수백 개에서 수천 개에 이르는 BlackHole 칩을 하나의 대규모 클러스터로 손쉽게 연결할 수 있다.
(출처: Tenstorrent)
워크로드 공동 설계(Workload Co-design)
Keller는 하이퍼스케일러와 최첨단 AI 연구소들이 수직 통합 구조를 갖추고 있기 때문에(즉, 자신들의 워크로드를 깊이 이해하고 있어 칩과 모델을 함께 설계할 수 있기 때문에) 하드웨어 설계에서 절대적인 우위를 가진다는 인식은 다소 과장된 측면이 있다고 말했다. Tenstorrent 역시 다른 기업들과 마찬가지로 일부 널리 사용되는 비선형 함수에 대해 하드웨어 수준의 최적화를 적용하고 있으며, 필요에 따라 이러한 기능은 차세대 실리콘에서 계속 개선해 나갈 수 있다고 설명했다.
Keller는 칩 설계에서 중요한 요소는 대규모 모델에 적합한 구조를 갖추는 것, 적절한 연산 정밀도를 확보하는 것, 그리고 대용량 KV 캐시와 디퓨전(Diffusion)처럼 연산량이 많은 워크로드를 모두 효율적으로 처리하는 것이라고 말했다.
"지금까지는 DRAM, SRAM, 연산 성능, Matrix-Vector 연산, 그리고 NoC(Network-on-Chip)의 균형만 잘 맞춰져 있다면 모든 것이 제대로 동작했습니다. Rent's Rule은 여전히 유효한 법칙인 것 같습니다."
또 다른 오래된 법칙으로는 암달의 법칙(Amdahl's Law)이 있다. 이 법칙은 일반적으로 전체 워크로드의 성능 향상은 가속할 수 없는 부분에 의해 결국 제한된다는 사실을 설명하는 데 사용된다.
"에이전트형 컴퓨팅(Agentic Computing)은 암달의 법칙이 그대로 적용되는 문제입니다." Keller는 이렇게 말했다. "AI는 엄청난 양의 연산을 필요로 했기 때문에 CPU는 AI 작업을 전달한 뒤 결과가 나올 때까지 기다리기만 하면 됐습니다. 하지만 이제 AI가 충분히 빨라지면서 병목이 오히려 일반적인 스칼라(Scalar) 연산 영역으로 이동했고, 그 결과 CPU의 중요성이 다시 커지고 있습니다."
IPO를 향한 행보
Keller는 Intel과 Qualcomm을 포함한 여러 기업의 인수 제안설에 대해서는 언급을 피했다. 다만 Tenstorrent의 하드웨어 IP를 소개하기 위해 두 회사의 CEO는 물론, 주요 하이퍼스케일러들과 실제로 만난 것은 사실이라고 밝혔다.
"우리의 RISC-V CPU IP는 정말 뛰어나기 때문에, 그들 가운데 한 곳과 큰 계약을 맺기를 기대하고 있습니다."
그는 이어 "한 하이퍼스케일러는 소형 AI 칩을 위해 우리의 AI IP에도 관심을 보이고 있습니다."라고 말했다.
Keller는 하이퍼스케일러들이 AI를 위한 자체 대형 칩을 개발하고 있지만, 엣지 디바이스에 사용되는 소형 AI 칩은 단순히 그 IP를 축소한 버전으로 해결할 수는 없다고 설명했다. Tenstorrent의 AI IP는 확장성을 고려해 설계되었으며, 이미 완전한 제품 형태로 제공되고 있다. (예를 들어 하나의 코어부터 최대 1,000개의 코어까지 확장하는 데 필요한 모든 요소를 갖추고 있다고 Keller는 설명했다.)
지난 6개월 동안 Tenstorrent의 경쟁 스타트업들은 (사실상의) 인수와 IPO라는 두 가지 큰 성과를 거뒀다. Keller는 Tenstorrent 역시 IPO를 목표로 하고 있으며, 이를 위해 공급망과 글로벌 사업 기반을 확대하고 있다고 밝혔다.
"현재 투자자들은 IPO에 매우 큰 기대를 걸고 있습니다."
그렇다면 Tenstorrent가 디코드 가속기로 활용될 수 있다는 점이 GPU 기업에게 매력적인 인수 대상이 될 가능성을 의미하는 것일까? Keller는 인수보다는 전략적 제휴나 공동 시장 진출(Joint Go-to-Market)이 이루어질 가능성이 더 높다고 말했다.
그는 국가 단위 AI 인프라(Sovereign Infrastructure)와 주요 프런티어 AI 연구소 모두 하드웨어와 소프트웨어에 대한 주도권을 직접 확보하기를 원한다고 설명하며, "앞으로 다양한 가능성이 열려 있습니다."라고 덧붙였다.
TT-Deploy 이후 Tenstorrent는 자사 하드웨어에 대한 주문을 받기 시작했으며, 가장 큰 구매 주문은 미국 외 지역으로 공급되는 Galaxy 서버 96대 규모의 클러스터라고 Keller는 밝혔다. (Galaxy 서버 96대는 BlackHole 칩 3,072개에 해당한다.) 현재 Tenstorrent의 최대 고객은 일본의 **AI&**이며, 이 회사의 CEO는 Tenstorrent의 전 임원인 David Bennett이다.
"실제로는 이런 일이 있었습니다. NVIDIA에 1억 달러 규모의 주문을 넣은 고객들이 있었지만, NVIDIA는 1년 동안 제품을 공급하지 못했습니다. 그래서 훨씬 저렴한 2천만 달러 규모의 Tenstorrent 시스템을 선택한 것입니다."라고 Keller는 말했다.
Keller는 Tenstorrent가 현재 Galaxy 서버 1,000대를 생산 중이며, 이 가운데 최소 절반 이상은 이미 판매가 완료된 상태라고 밝혔다.
"우리 제품은 매우 잘 작동하고 있습니다. 현재 10개 고객사가 이미 Galaxy 시스템을 현장에 구축해 사용하고 있으며, 우리는 이제 개념검증(PoC) 단계를 넘어섰습니다." Keller는 이어 "후속 주문도 들어오기 시작했습니다. 이제 만족하는 고객 10곳을 만들고, 그다음에는 20곳, 그리고 30곳으로 늘려가는 것이 목표입니다."라고 말했다.
출처: EE Times