대형 언어 모델(LLM)이 현대 애플리케이션의 핵심 요소로 자리잡으면서, 이를 배포할 서버를 적절히 선택하는 것이 그 어느 때보다 중요해졌습니다. 엔터프라이즈가 추론을 확장하거나, 스타트업이 비용 최적화를 꾀하거나, 연구자가 처리량의 한계를 실험하는 경우까지 포함됩니다. 본 블로그는 데이터센터용으로 흔히 사용되지 않는 구성 두 가지와, 주류 고성능 서버 구성 두 가지를 비교합니다. 각 구성은 고유한 GPU 또는 가속기를 탑재하고 있으며, vLLM 프레임워크를 기반으로 측정하였습니다.
비교 대상은 다음과 같습니다:
AMD MI300X
NVIDIA H200
Tenstorrent n300s
AMD RX 7900 XTX
RX 7900 XTX를 데이터센터급 GPU와 비교하는 것은 다소 불공정할 수 있으나, 이 카드가 지닌 다목적성은 주목할 만합니다. 고성능 게이밍과 AI 개발 모두를 지원하는 다용도 GPU로, 개발과 여가를 동시에 하나의 시스템에서 수행할 수 있다는 실용적인 이점이 있습니다. 이는 개인 개발자나 소규모 팀, 또는 수요에 따라 게이밍과 AI 워크로드를 동적으로 전환하려는 데이터센터에 매력적인 옵션이 될 수 있습니다.
참고로, RX 7900 XTX를 본 비교에 포함한 이유는 단순히 우리가 해당 GPU를 이미 보유하고 있었고, 데이터센터 전용 하드웨어와 비교했을 때의 성능이 궁금했기 때문입니다.
또 다른 특이한 비교 대상은 Tenstorrent 시스템입니다. 약 3년 전 처음 주목받기 시작한 이후로 높은 잠재력을 보여주고 있으며, AI 시장의 양대 강자에 신선한 변화를 더하기 위해 본 테스트에 포함하였습니다 (Intel에는 미안한 이야기입니다).
가속기
아키텍처
VRAM
메모리 종류
TDP
가격(USD)
| AMD MI300X | CDNA3 | 192GB | HBM3 | 750W | 약 $15,000 |
| NVIDIA H200 | Hopper | 141GB | HBM3e | 700W | 약 $30,000 |
| AMD RX 7900 XTX | RDNA3 | 24GB | GDDR6 | 355W | 약 $1,000 |
| Tenstorrent n300s | Custom RISC-V | 24GB | GDDR6 | 300W | 약 $1,399 |
※ 실제 성능은 CPU, 메인보드, 냉각 시스템 등 통합 환경과 워크로드에 따라 달라질 수 있습니다. 본 비교는 GPU/가속기 자체에 중점을 두었습니다.
전력 측정 방식
MI300X와 H200은 단일 GPU 가격이 공개되어 있지 않기 때문에, 전체 시스템 가격과 전력 소비량을 기준으로 100만 토큰당 비용을 계산하였습니다. 실제 배포 환경에서는 GPU 가격 외에도 전력, 하드웨어, 인프라 등의 시스템 레벨 비용이 운영비에 큰 영향을 미치므로, 이러한 접근 방식이 더 현실적입니다.
계산은 GPU 수량 기준 토큰 처리량과 소비 전력, 전체 시스템의 대기 전력을 합산하여 산출되었습니다. 모든 GPU가 최대 활용된다는 가정 하에, 시스템 전체 비용과 전력을 GPU별로 분배한 구조입니다.
※ H200 시스템의 대기 전력은 기사에서 인용된 약 2200W 기준입니다 (ServeTheHome 기사 참조). RX 7900 시스템은 약 400W로 추정되었으며, 다른 시스템은 ipmitool을 사용해 측정하였습니다.
서버CPURAM저장장치냉각GPU 수대기 전력(예상)시스템 가격
| A+ Server 8125GS-TNMR2 | 2x EPYC 9654 | 1536GB | 4TB NVMe | 공냉 | 8 | 약 2400W | 약 $260,564 |
| SuperServer 821GE-TNHR | 2x Xeon Platinum 8468H | 1536GB | 4TB NVMe | 공냉 | 8 | 약 2200W | 약 $307,336 |
| DIY AMD 워크스테이션 | Ryzen 9 7950X | 64GB | 2TB NVMe | 공냉 | 2 | 약 400W | 약 $3,500 |
| Tenstorrent Loudbox | 2x Xeon Silver 4309Y | 512GB | 4TB NVMe | 패시브 | 4 | 약 700W | $12,000 |
※ 구성은 대표적인 예시입니다. 실제 구축 환경에 따라 사양과 비용이 달라질 수 있습니다.
벤치마크 구성
프레임워크: vLLM (paged attention + continuous batching)
모델: Meta-Llama-3-8B-Instruct
워크로드: 동시 프롬프트 처리, 배치 크기 32, 출력 길이 256 tokens
데이터셋: ShareGPT
측정 지표: tokens/sec (처리량) 및 비용-성능 지수
vLLM 벤치마크 결과 (Batch Size 32 기준)
| AMD MI300X | 8 | 7003.10 | 56,024.8 |
| NVIDIA H200 | 8 | 8192.08 | 65,536.64 |
| AMD RX 7900 XTX | 2 | 1113.59 | 2227.18 |
| Tenstorrent Loudbox | 4 | 1314.0 | 5256.0 |
※ RX 7900 XTX는 컨텍스트 길이 131072에서 OOM 오류가 발생하여 22048로 낮추어 테스트 진행하였습니다.
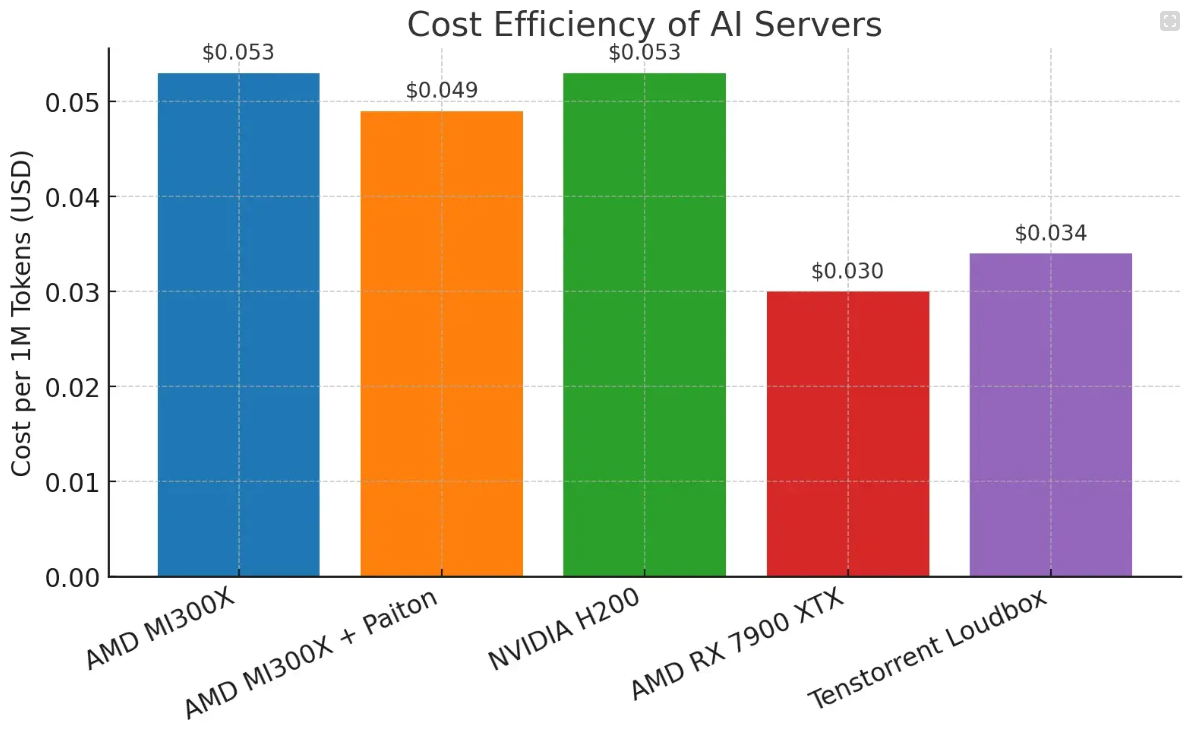
100만 토큰당 비용
3년 사용 수명(총 26280시간) 기준, 전력요금은 $0.10/kWh로 계산
| AMD MI300X | $0.053 |
| AMD MI300X + Paiton | $0.049 |
| NVIDIA H200 | $0.053 |
| AMD RX 7900 XTX | $0.030 (짧은 컨텍스트 기준) |
| Tenstorrent Loudbox | $0.034 |
분석 요약
AMD MI300X: 대용량 VRAM 기반의 안정적 처리량 제공. Llama 3-70B 이상과 같은 대형 모델에 적합. 단일 GPU로 큰 모델이 안 올라가는 상황 때문에 8B 모델 기준 비교를 했지만, 이 GPU는 원래 그런 용도엔 부적합하며, 파티셔닝 필요.
MI300X + Paiton: 소프트웨어 최적화(Paiton 프레임워크)로 8.2% 비용 절감 효과. 지속적인 성능 향상 기대됨.
NVIDIA H200: 최고 수준의 처리 속도와 CUDA 소프트웨어 생태계로 쉬운 사용성 제공.
RX 7900 XTX: 개인 개발자에 적합한 가성비 시스템. VRAM 한계와 컨텍스트 길이 제약으로 대규모 작업에는 부적합하지만, 가벼운 추론/개발에는 유용.
Tenstorrent n300s: RISC-V 기반 ML 특화 아키텍처. vLLM 등 추론 프레임워크에서의 지원은 증가 추세. 특정 모델 지원 여부 확인 필요.
결론
서버 선택은 사용 목적에 따라 달라집니다:
스타트업/연구자: RX 7900 XTX 또는 Tenstorrent Loudbox → 저비용 테스트 및 추론에 적합 (단, 모델 호환 여부 필수 확인)
엔터프라이즈: MI300X 및 H200 → 고성능과 효율성의 균형. MI300X는 특히 더 큰 VRAM을 제공하면서도 가격 경쟁력이 높음.
RX 7900 XTX의 경쟁력 있는 비용 효율성을 바탕으로, 현재 Paiton 프레임워크는 RDNA 지원도 개발 중이며 이 GPU의 잠재력을 더욱 확장할 예정입니다.
빠르게 진화하는 AI 하드웨어 시장에서, vLLM과 같은 최적화된 추론 프레임워크와 올바른 가속기 조합이 인프라 성능 극대화의 핵심이 될 것입니다.
출처: https://eliovp.com/mi300x-vs-h200-vs-rx-7900-xtx-vs-tenstorrent-n300s-with-vllm/

대형 언어 모델(LLM)이 현대 애플리케이션의 핵심 요소로 자리잡으면서, 이를 배포할 서버를 적절히 선택하는 것이 그 어느 때보다 중요해졌습니다. 엔터프라이즈가 추론을 확장하거나, 스타트업이 비용 최적화를 꾀하거나, 연구자가 처리량의 한계를 실험하는 경우까지 포함됩니다. 본 블로그는 데이터센터용으로 흔히 사용되지 않는 구성 두 가지와, 주류 고성능 서버 구성 두 가지를 비교합니다. 각 구성은 고유한 GPU 또는 가속기를 탑재하고 있으며, vLLM 프레임워크를 기반으로 측정하였습니다.
비교 대상은 다음과 같습니다:
AMD MI300X
NVIDIA H200
Tenstorrent n300s
AMD RX 7900 XTX
RX 7900 XTX를 데이터센터급 GPU와 비교하는 것은 다소 불공정할 수 있으나, 이 카드가 지닌 다목적성은 주목할 만합니다. 고성능 게이밍과 AI 개발 모두를 지원하는 다용도 GPU로, 개발과 여가를 동시에 하나의 시스템에서 수행할 수 있다는 실용적인 이점이 있습니다. 이는 개인 개발자나 소규모 팀, 또는 수요에 따라 게이밍과 AI 워크로드를 동적으로 전환하려는 데이터센터에 매력적인 옵션이 될 수 있습니다.
참고로, RX 7900 XTX를 본 비교에 포함한 이유는 단순히 우리가 해당 GPU를 이미 보유하고 있었고, 데이터센터 전용 하드웨어와 비교했을 때의 성능이 궁금했기 때문입니다.
또 다른 특이한 비교 대상은 Tenstorrent 시스템입니다. 약 3년 전 처음 주목받기 시작한 이후로 높은 잠재력을 보여주고 있으며, AI 시장의 양대 강자에 신선한 변화를 더하기 위해 본 테스트에 포함하였습니다 (Intel에는 미안한 이야기입니다).
가속기 아키텍처 VRAM 메모리 종류 TDP 가격(USD)
※ 실제 성능은 CPU, 메인보드, 냉각 시스템 등 통합 환경과 워크로드에 따라 달라질 수 있습니다. 본 비교는 GPU/가속기 자체에 중점을 두었습니다.
전력 측정 방식
MI300X와 H200은 단일 GPU 가격이 공개되어 있지 않기 때문에, 전체 시스템 가격과 전력 소비량을 기준으로 100만 토큰당 비용을 계산하였습니다. 실제 배포 환경에서는 GPU 가격 외에도 전력, 하드웨어, 인프라 등의 시스템 레벨 비용이 운영비에 큰 영향을 미치므로, 이러한 접근 방식이 더 현실적입니다.
계산은 GPU 수량 기준 토큰 처리량과 소비 전력, 전체 시스템의 대기 전력을 합산하여 산출되었습니다. 모든 GPU가 최대 활용된다는 가정 하에, 시스템 전체 비용과 전력을 GPU별로 분배한 구조입니다.
※ H200 시스템의 대기 전력은 기사에서 인용된 약 2200W 기준입니다 (ServeTheHome 기사 참조). RX 7900 시스템은 약 400W로 추정되었으며, 다른 시스템은 ipmitool을 사용해 측정하였습니다.
서버CPURAM저장장치냉각GPU 수대기 전력(예상)시스템 가격
※ 구성은 대표적인 예시입니다. 실제 구축 환경에 따라 사양과 비용이 달라질 수 있습니다.
벤치마크 구성
프레임워크: vLLM (paged attention + continuous batching)
모델: Meta-Llama-3-8B-Instruct
워크로드: 동시 프롬프트 처리, 배치 크기 32, 출력 길이 256 tokens
데이터셋: ShareGPT
측정 지표: tokens/sec (처리량) 및 비용-성능 지수
vLLM 벤치마크 결과 (Batch Size 32 기준)
※ RX 7900 XTX는 컨텍스트 길이 131072에서 OOM 오류가 발생하여 22048로 낮추어 테스트 진행하였습니다.
100만 토큰당 비용
3년 사용 수명(총 26280시간) 기준, 전력요금은 $0.10/kWh로 계산
분석 요약
AMD MI300X: 대용량 VRAM 기반의 안정적 처리량 제공. Llama 3-70B 이상과 같은 대형 모델에 적합. 단일 GPU로 큰 모델이 안 올라가는 상황 때문에 8B 모델 기준 비교를 했지만, 이 GPU는 원래 그런 용도엔 부적합하며, 파티셔닝 필요.
MI300X + Paiton: 소프트웨어 최적화(Paiton 프레임워크)로 8.2% 비용 절감 효과. 지속적인 성능 향상 기대됨.
NVIDIA H200: 최고 수준의 처리 속도와 CUDA 소프트웨어 생태계로 쉬운 사용성 제공.
RX 7900 XTX: 개인 개발자에 적합한 가성비 시스템. VRAM 한계와 컨텍스트 길이 제약으로 대규모 작업에는 부적합하지만, 가벼운 추론/개발에는 유용.
Tenstorrent n300s: RISC-V 기반 ML 특화 아키텍처. vLLM 등 추론 프레임워크에서의 지원은 증가 추세. 특정 모델 지원 여부 확인 필요.
결론
서버 선택은 사용 목적에 따라 달라집니다:
스타트업/연구자: RX 7900 XTX 또는 Tenstorrent Loudbox → 저비용 테스트 및 추론에 적합 (단, 모델 호환 여부 필수 확인)
엔터프라이즈: MI300X 및 H200 → 고성능과 효율성의 균형. MI300X는 특히 더 큰 VRAM을 제공하면서도 가격 경쟁력이 높음.
RX 7900 XTX의 경쟁력 있는 비용 효율성을 바탕으로, 현재 Paiton 프레임워크는 RDNA 지원도 개발 중이며 이 GPU의 잠재력을 더욱 확장할 예정입니다.
빠르게 진화하는 AI 하드웨어 시장에서, vLLM과 같은 최적화된 추론 프레임워크와 올바른 가속기 조합이 인프라 성능 극대화의 핵심이 될 것입니다.
출처: https://eliovp.com/mi300x-vs-h200-vs-rx-7900-xtx-vs-tenstorrent-n300s-with-vllm/